context length exceeded 怎么解决?长历史、文件与输出预算检查
上下文超限,说明请求超过了模型或渠道接受的输入输出条件。不是只数最后一句话的长度。系统提示、历史、文件内容、工具结果和预留输出都可能影响请求规模。
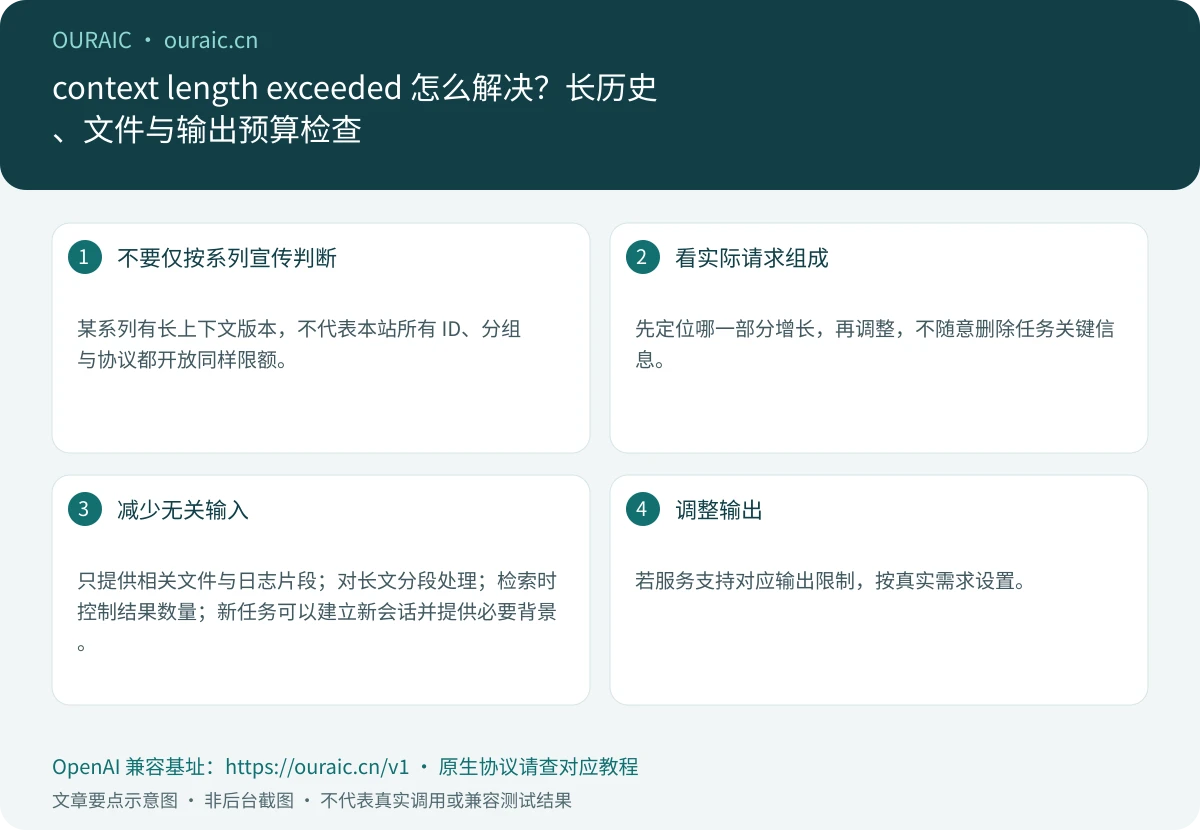
图:按本文操作要点制作的说明图,不是后台或调用成功截图。
不要仅按系列宣传判断
某系列有长上下文版本,不代表本站所有 ID、分组与协议都开放同样限额。查看当前模型说明,并在目标组合中测试,不从旧文章引用一个固定数字。
模型名字含相似后缀,也不能代替具体限制核验。
看实际请求组成
| 部分 | 可能的增长来源 |
|---|---|
| 系统提示 | 大量固定规则 |
| 聊天历史 | 每轮重复发送 |
| 文件 | 整库或无关目录 |
| 工具结果 | 长日志、网页或检索结果 |
| 输出预算 | 预留大量生成空间 |
先定位哪一部分增长,再调整,不随意删除任务关键信息。
减少无关输入
只提供相关文件与日志片段;对长文分段处理;检索时控制结果数量;新任务可以建立新会话并提供必要背景。
自动摘要会丢失细节,重要约束、文件路径和验收条件应明确保留。不能假定摘要后的任务与完整原文完全相同。
调整输出
若服务支持对应输出限制,按真实需求设置。不同接口或模型参数不必相同,不能把一种参数名复制到全部请求。
输入已经超限时,仅降低输出并不一定足够,仍需检查总条件。
编程 Agent 的情况
长会话、反复读取文件和工具输出会累积上下文。明确任务范围、分阶段完成并保留可复查结果,比持续向同一会话追加所有文件更有效。
压缩不是失败的唯一证据,是否需要压缩应按任务与工具行为判断,不用固定百分比解释所有项目。
验证与费用
减少输入后用同一模型测试,再核对日志。上下文变短可能减少成本,但不能保证输出质量不变,需要检查任务结果。
长上下文价格可能存在阶梯,查当前定价规则。费用基础见 token 估算。